新腾讯混元
腾讯混元AIGC视频生成模型,一键生成电影画质视频,动作自然、表达精准,满足广告影视等商业场景。
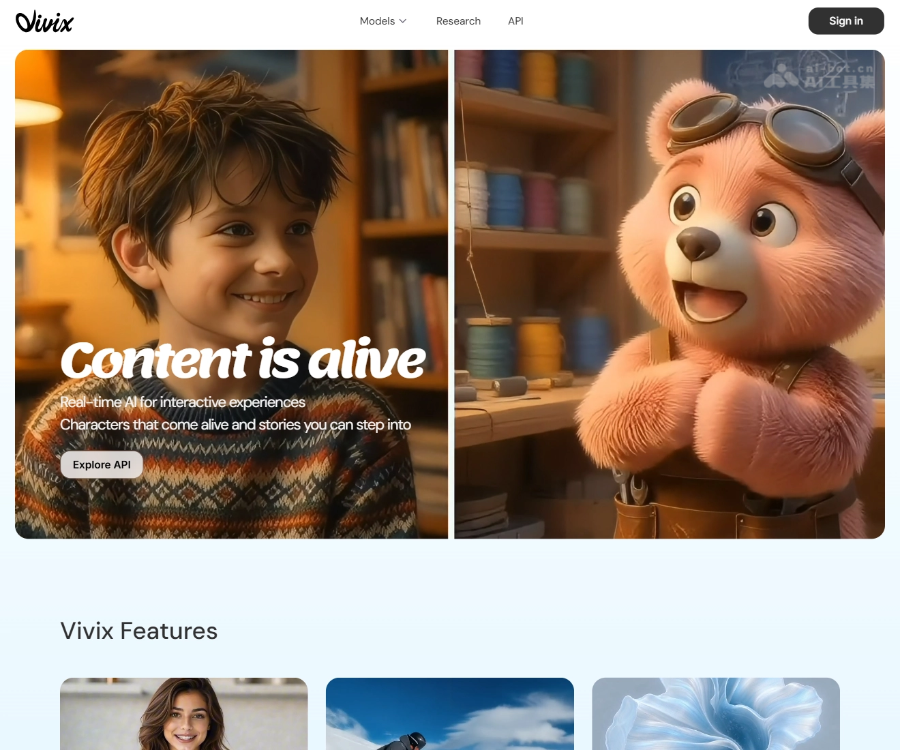
 Vivix
Vivix 是一个面向实时多模态 AI 的构建平台,官网地址为 https://vivix.ai。其核心能力在于将文本、图像、视频与语音四种模态整合进同一套模型体系,使开发者与创作者能够构建可实时交互的角色、场景与虚拟世界。与仅支持单一输入输出形式的工具不同,Vivix 强调的是”多模态并行处理”与”实时响应”这两项特性,这使其更接近交互式应用的底层基础设施,而非单纯的生成工具。
Vivix 支持的模态覆盖当前主流的四类信息载体:
| 模态 | 典型用途 |
|---|---|
| 文本 | 角色对话、剧情推进、指令理解 |
| 图像 | 场景视觉生成、角色形象设定 |
| 视频 | 动态场景渲染、实时画面反馈 |
| 语音 | 语音交互、角色配音、实时对话 |
四种模态并非孤立运作,而是可以在同一交互流程中协同。例如用户以语音输入指令,系统以文本理解意图、以图像与视频呈现反馈,形成闭环。
“实时”是 Vivix 定位中的关键限定词。传统多模态模型多采用”请求—等待—返回”的批处理模式,而实时性意味着模型需在交互过程中持续输出,适用于虚拟角色对话、互动叙事、沉浸式场景等对延迟敏感的场景。
Vivix 将构建对象划分为三个层次:
这一分层结构便于开发者按需组合,从单一角色对话应用起步,逐步扩展至更完整的世界构建。
从能力特征推断,Vivix 的主要使用者包括:
对于初次接触的团队,建议按以下路径评估:
Vivix 的差异化在于将多模态生成与实时交互合并到同一平台,并以角色、场景、世界三层结构组织构建对象。它更适合需要”持续互动”而非”一次性生成”的应用场景。是否契合具体项目,取决于团队对实时性与多模态协同的实际需求强度,建议以小型原型先行验证。