新Cherry Studio
开源免费的AI桌面客户端,支持AI对话、绘图、知识库及主流大模型,数据本地存储。
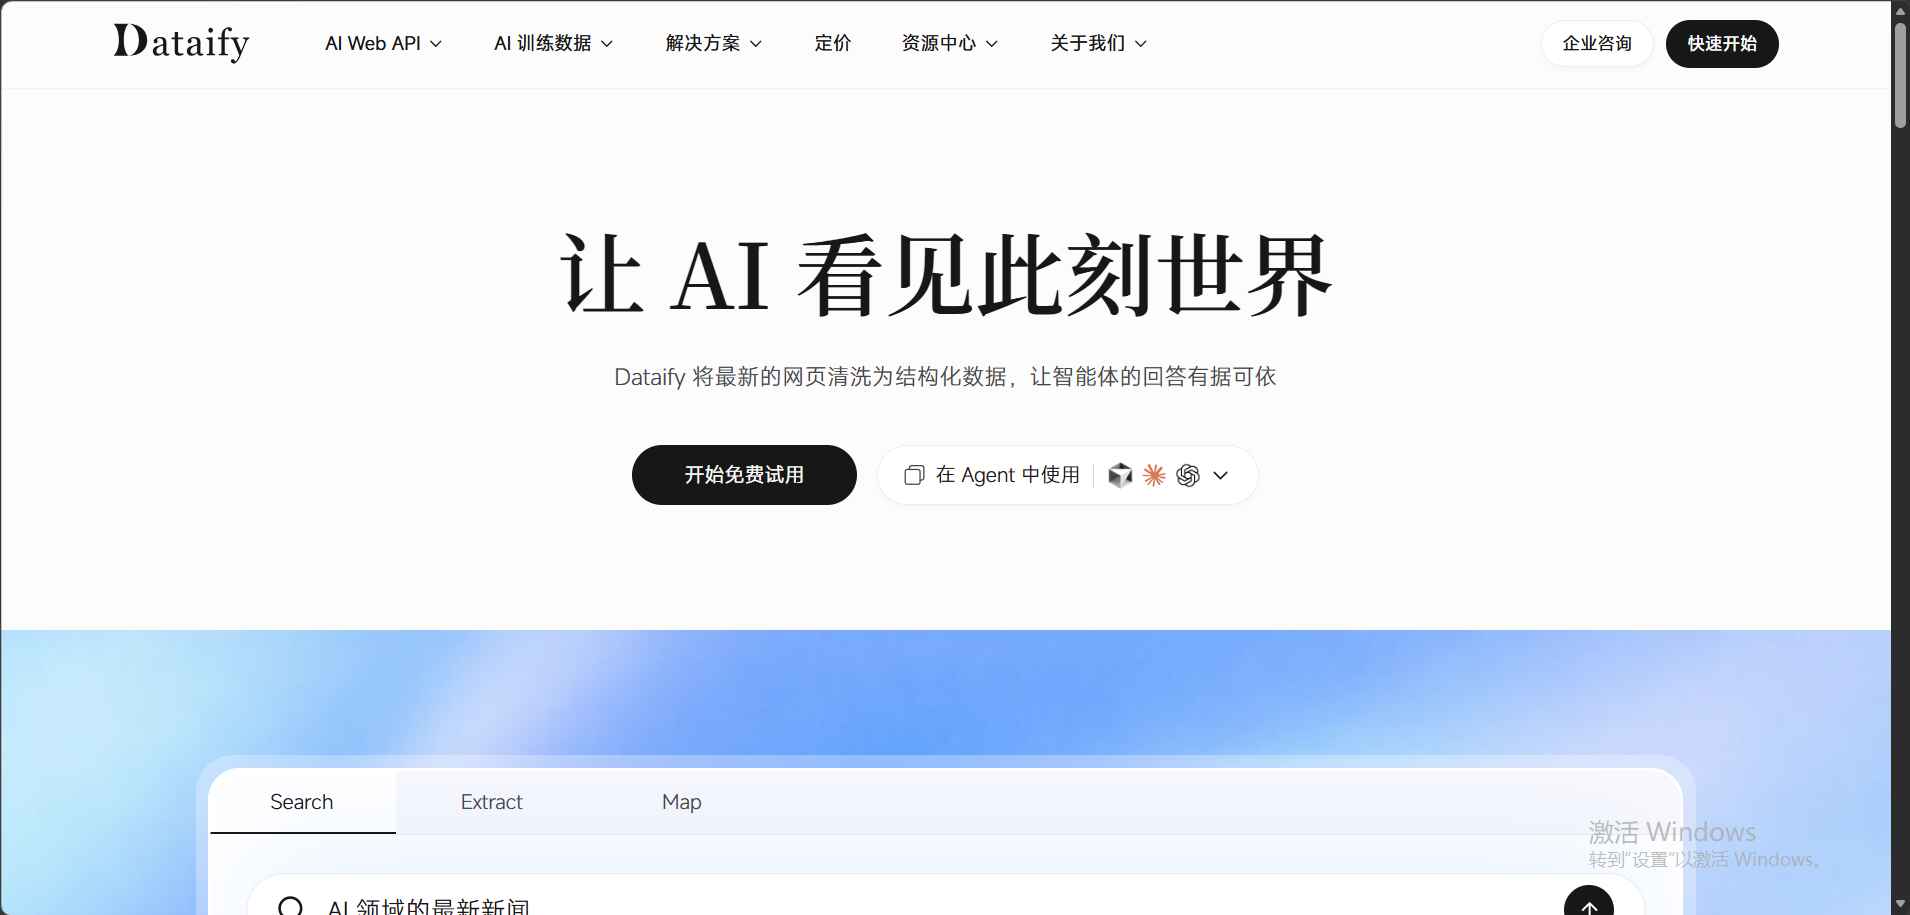
Dataify 是一个面向模型训练与智能体开发的实时数据基础设施。它解决的核心问题是:当公开静态数据集逐渐无法满足生产级 AI 对时效性和场景覆盖的要求时,团队如何持续、稳定地获取可用的网页数据与多模态训练语料。
平台将实时网页抓取、数据结构化处理与训练集生成整合为一条可复用的流水线,目标用户包括机器学习工程师、数据产品团队以及构建 RAG 或 Agent 应用的开发者。
Dataify 提供对公开网页内容的持续采集与更新能力。与传统一次性爬取不同,平台支持按频率、按触发条件维护数据的新鲜度,并将原始 HTML、文本快照、元数据分层存储。
除文本外,平台支持图像与文本配对数据的整理与标注辅助,适用于图文理解、视觉问答、跨模态检索等任务的训练数据准备。
针对 Agent 场景,Dataify 提供面向工具调用与上下文检索的数据格式预设。开发者可以将采集结果直接接入向量数据库或作为 Function Calling 的示例集。
| 功能模块 | 适用场景 | 输出形态 |
|---|---|---|
| 实时采集 | 舆情监控、竞品追踪 | 增量数据流 |
| 数据集构建 | 模型微调、评测基准 | 版本化数据集 |
| Agent 数据适配 | RAG 语料、工具示例 | 格式化 JSON Schema |
平台在数据管道的三个环节做了针对性设计:
Dataify 采用按量计费与订阅结合的定价模式。新用户可创建有限额的项目进行验证,确认数据质量和格式符合需求后再扩展规模。平台提供 REST API 与 Python SDK,文档覆盖从创建采集任务到导出数据集的完整流程。
对于不确定数据源可用性或格式要求的团队,建议先以单个数据源做小批量验证,明确字段定义与更新频率后再纳入正式训练流程。