苏打办公
360旗下办公导航站,聚合海量优质工具,提升办公与生活效率。
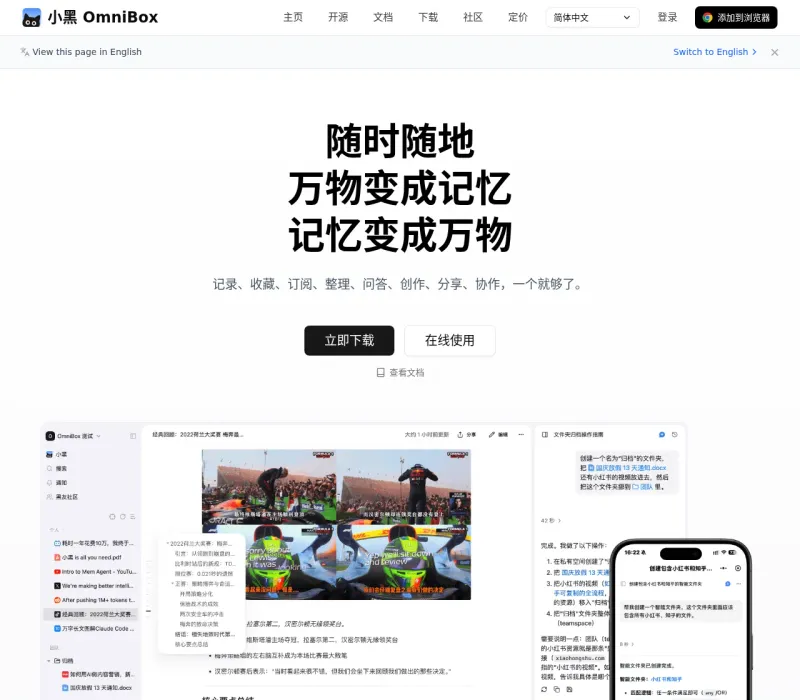
小黑 OmniBox 是一款面向知识工作者的 AI 工具,核心逻辑是把散落在不同环节的信息处理工作——收集、解析、整理、输出——收拢到同一条工作流里。它不试图替代某一类单独的工具,而是解决一个更具体的问题:当资料以网页、文档、笔记等多种形态存在时,如何低成本地把它们转化为可检索、可复用的知识资产。
支持从多个来源导入信息,包括网页剪藏、文本粘贴和文件上传。收集环节的定位是“低摩擦”:不需要预先分类,也不强制填写元数据,先把内容放进来,结构在后续环节再逐步形成。
OmniBox 对上传文件做内容提取与结构化处理,覆盖常见格式,如 PDF、Word、Markdown、纯文本等。解析结果保留原文层级,同时生成可供检索和问答引用的文本片段。需要说明的是,解析质量会因文件本身的排版复杂度而有所差异,扫描件或含大量表格、图片的文档可能需要人工校对。
整理功能的核心是“关联”而非“归档”。系统会根据内容之间的语义关系建议关联条目,用户也可以手动建立链接。长期使用后,知识库会形成一定的网络结构,使旧内容在相关场景下被重新调用,而不是沉底。
基于已收集和整理的内容,OmniBox 提供问答和文本生成能力。与通用对话工具的区别在于,回答会优先引用用户自己的知识库内容,并尽量标注来源。这在需要事实依据的场景下更有参考价值,但引用准确性仍取决于知识库本身的质量和覆盖度。
| 场景 | 典型用法 |
|---|---|
| 研究调研 | 收集多来源资料,统一解析后按主题整理,辅助形成综述或报告初稿 |
| 个人知识管理 | 将零散笔记和文章集中管理,通过问答方式回溯和调用旧内容 |
| 内容创作 | 基于已有素材生成提纲、摘要或扩展文本,减少从空白开始的启动成本 |
OmniBox 适合那些已经有一定资料积累、且希望减少在不同工具之间来回切换的知识工作者。它的价值不在单一功能的强大,而在流程的连贯性。是否适合你,取决于你当前的工作流是否正被“收集—整理—输出”之间的断层所困扰。