核心定位
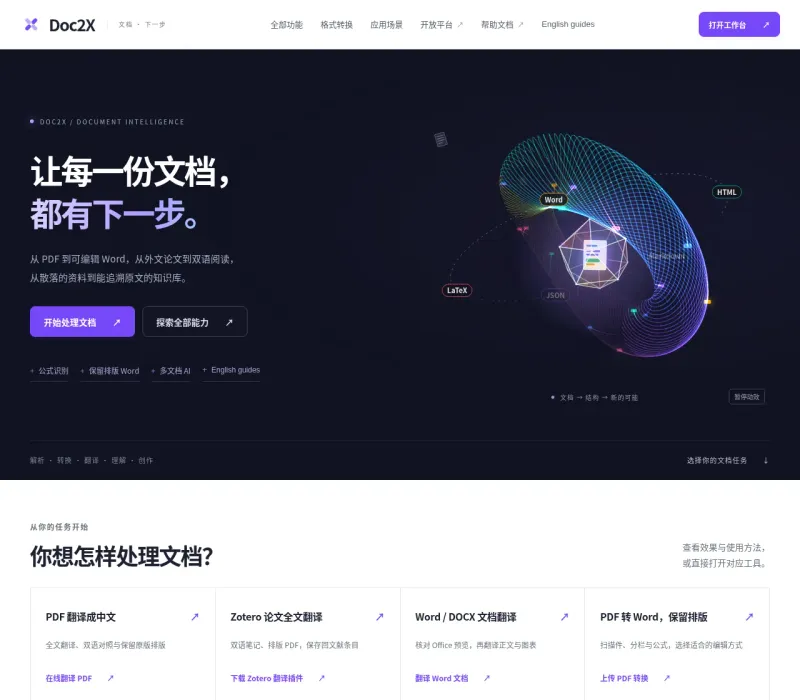
Doc2X 是一个面向文档处理全流程的在线工具平台,主要解决 PDF 转 Word、数学公式识别、文档翻译以及知识库构建四类高频需求。与单一功能的转换工具不同,它将文档的结构化解析、内容提取与后续利用放在同一套工作流中完成。
主要功能
1. PDF 转 Word
- 支持保留原始排版结构,包括段落、表格、页眉页脚等元素
- 针对扫描件提供 OCR 识别路径,非纯文本型 PDF 也可转换
- 输出格式兼容主流办公软件,减少二次排版成本
2. 公式识别
- 可识别 PDF 或图片中的数学、物理、化学公式
- 输出 LaTeX 或 MathML 格式,便于学术写作与排版系统对接
- 对复杂符号、上下标、矩阵等结构有针对性优化
3. 文档翻译
- 支持整篇文档翻译,保留原格式输出
- 适用于学术论文、技术手册等专业文本
- 翻译结果可直接导出为可编辑格式
4. AI 知识库
- 将上传的文档转化为可检索、可问答的知识库
- 支持基于文档内容进行自然语言提问
- 适合将散落的 PDF 资料整合为可复用的信息资产
适用场景
| 场景 |
对应功能 |
典型用户 |
| 学术写作 |
公式识别 + 翻译 |
研究生、科研人员 |
| 办公文档处理 |
PDF 转 Word |
行政、文员、编辑 |
| 资料管理 |
AI 知识库 |
分析师、咨询师 |
| 跨语言阅读 |
文档翻译 |
技术人员、学生 |
使用路径
- 上传目标 PDF 或图片文件
- 选择所需功能(转换、识别、翻译或入库)
- 等待处理完成后下载或在线查看结果
- 如需构建知识库,可将多份文档批量导入后统一管理
注意事项
- 转换效果受源文件清晰度与排版复杂度影响,扫描件建议先确认 OCR 质量
- 公式识别对拍摄角度和光照有一定要求,尽量使用正向、清晰的图片
- 翻译功能适合技术类文本,文学性较强的内容可能需要人工润色
- 知识库的问答效果取决于上传文档的质量与覆盖范围
Doc2X 将文档处理链条上的多个环节集中在一个平台,减少了工具切换带来的格式损耗与时间成本。对于需要频繁处理 PDF、学术文献或构建私有资料库的用户,可以将其作为日常流程中的固定环节来评估。