
GitMind
全平台在线思维导图与流程图制作工具,支持多端同步,提供海量模板。
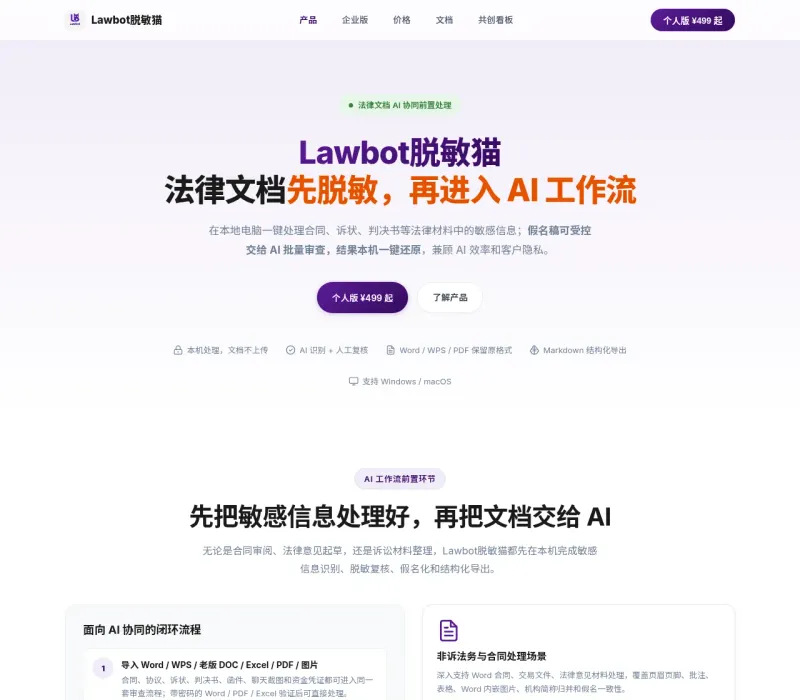
 Lawbot脱敏猫
是一款面向法律文档处理流程的前置工具,解决的是法律数据在进入AI模型或第三方平台之前的敏感信息控制问题。它的核心功能集中在本地识别与假名化处理,不依赖云端完成关键步骤。
系统在本地环境中对法律文档进行扫描,识别常见敏感字段,包括但不限于:
| 信息类别 | 示例 |
|---|---|
| 身份标识 | 姓名、身份证号、护照号 |
| 联系信息 | 电话、邮箱、住址 |
| 案件信息 | 案号、当事人名称、代理律师 |
| 财务数据 | 银行账号、金额、税务编号 |
识别过程在本地完成,原始文档无需上传至外部服务器,降低了数据暴露面。
识别出的敏感信息可被替换为一致性假名。所谓一致性,是指同一实体在整份文档或跨文档处理中保持相同的替代标识,避免破坏文档内部逻辑关联。例如,同一当事人出现在不同段落时,替换结果保持一致,便于后续阅读与AI处理。
处理后的文档可直接用于大语言模型或法律AI工具。假名化后的文本保留了文档结构和语义完整性,同时剥离了真实敏感数据,适合用于模型微调、案例检索测试或跨团队协作场景。
工具采用本地处理架构,核心识别与替换逻辑均在用户侧执行。这一设计使得:
对于需要频繁将法律文档输入AI工具的用户,建议将脱敏猫纳入固定工作流:先本地识别处理,再进入下游AI环节。处理前确认识别规则覆盖所需字段类型,处理后抽查关键段落验证假名一致性。